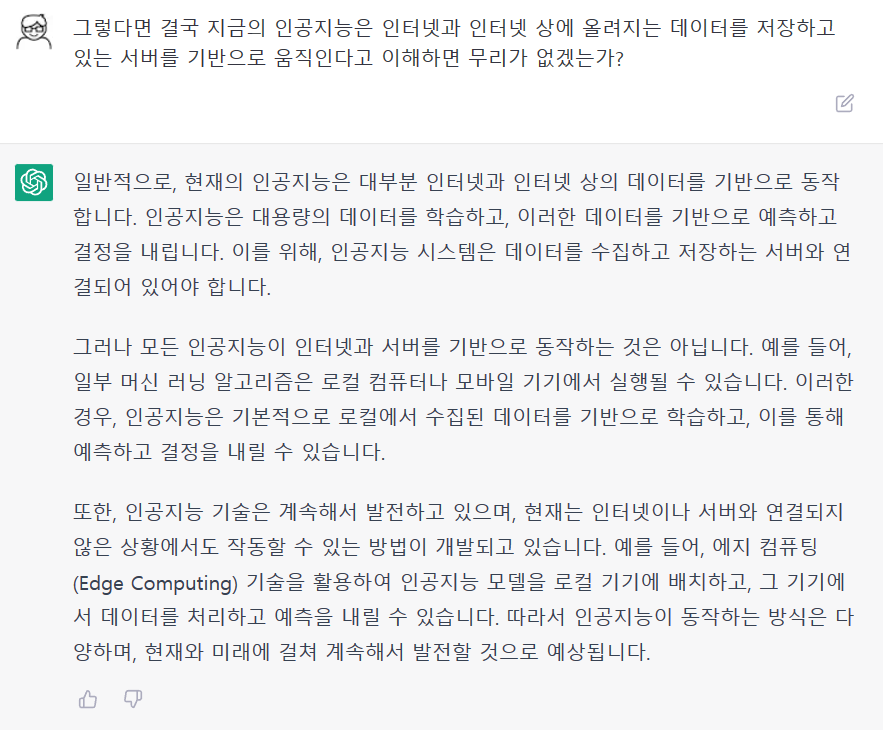
사람들이 하도 ‘아포칼립틱’한 이야기를 많이 해서 내가 예전부터 생각해오던 것을 챗GPT에게 함 물어봤다. 그리고 내가 생각하던 바가 어느 정도 들어맞는다는 확인을 나름 받았다.
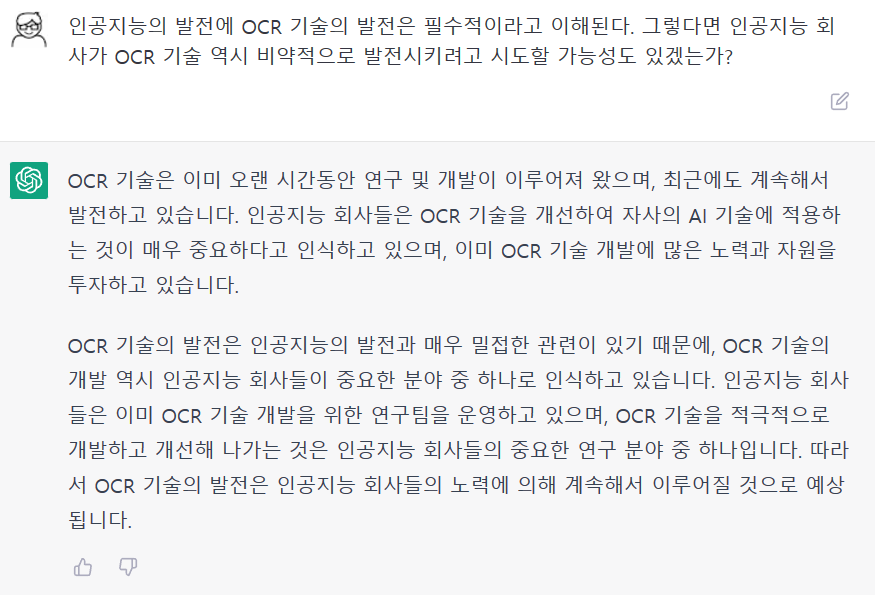
나는 지금의 (검색형) AI가 무슨 재주를 부려도 전 세계 서버에 있는 데이터, 그것도 인터넷 상에 공개된 데이터로 움직일 수밖에 없다는 한계가 있다고 생각한다(이 글을 보라). 그리고 사실, 인터넷, 그리고 서버는 나온 지 얼마 안 된 물건이다. 그러므로 인류가 그간 생산해온 지식을 모두 데이터로 삼으려면 아직까지는 시간이 많이 필요하다고 보았다. 기본적으로 인류가 이제까지 만들어낸 정보 저장 매체는 죄다 ‘아날로그’이기 때문이다. 그러니 OCR 기술이 얼마나 빨리 고도화되는가에 따라 AI도 발전할 것이라 보았다. 그래서 아래와 같이 챗GPT(이름이 참 공교롭다, ‘췟!‘이라니)와 ‘채팅’했다.

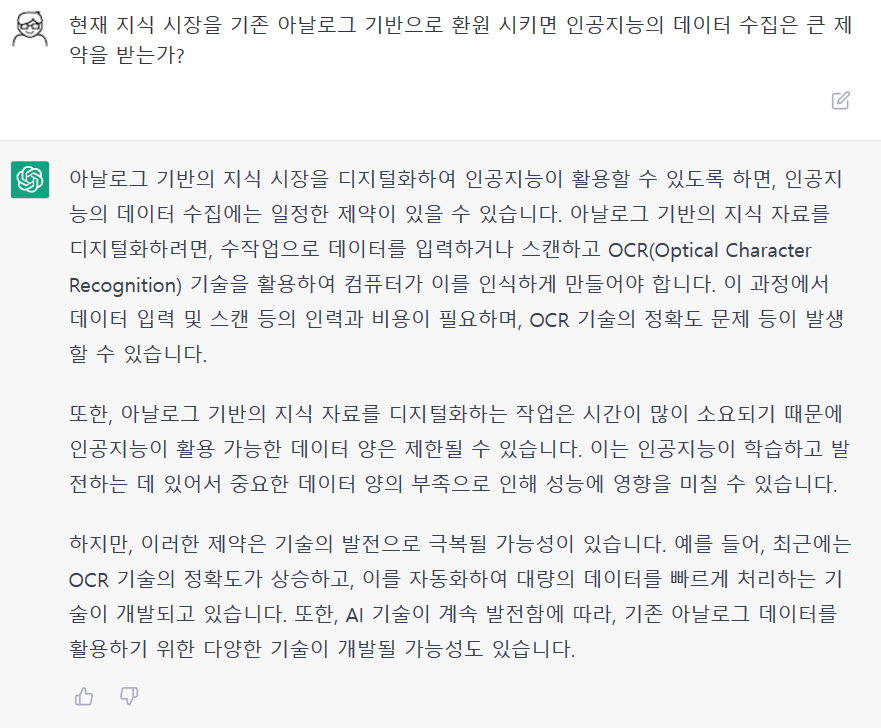
앞으로 AI에 대한 일종의 러다이트식 저항은 아마도 ‘서버 때려부수기’로 나타날 공산이 있다. ㅎㅎㅎ 그러나 AI에 대한 더욱 현실성 있는 저항 혹은 더 나아가서 대안은 지식 생산자들이 자기 생산물을 아날로그로만 생산하고, 디지털화 시키지 않는 것이다. 물론, 이렇게 되면 기존 디지털-인터넷 생태계에서 퇴거하는 것이므로 고립을 감수해야 한다. 하지만, 과거 지식은 몰라도 미래 지식은 이러한 ‘디지털 보이콧’으로 AI의 DB가 되는 것을 막을 수 있을 것이다, 실현 가능 여부와는 별개로.
아마 앞으로 OCR 관련 주식을 사 모으면 돈이 되지 싶다. ㅎㅎㅎ 그리고 OCR쪽의 특허 등을 개발하는 사람은 대박 나지 싶다.
이 글도 보라.
